

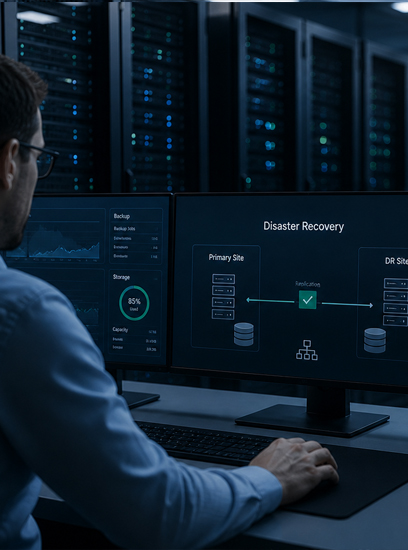
Donanım arızası, fidye yazılımı, yangın, su baskını, deprem veya yanlışlıkla silinen bir veritabanı: Felaket kurtarma planı, bu olaylardan hangisi yaşanırsa yaşansın iş süreçlerinin ne kadar sürede ve ne kadar veri kaybıyla geri döneceğini önceden belirler. İyi bir plan teknolojiyle değil, iş gereksinimleriyle başlar.
Yedekleme ile felaket kurtarma aynı şey değildir
- Yedekleme, verinin bir kopyasını almaktır. Bir dosya veya sanal makine kaybolduğunda geri getirmeyi sağlar.
- Felaket kurtarma (DR), birincil veri merkezi tamamen kullanılamaz hale geldiğinde sistemlerin başka bir lokasyonda ayağa kalkmasını sağlayan altyapı, süreç ve insandır.
Yedek, DR’ın parçasıdır ama tek başına DR değildir: Yüzlerce sanal makineyi yalnızca yedekten, sıfırdan kurulacak bir altyapıya geri yüklemek günler sürebilir.
İş gereksinimlerini belirleyin: RPO ve RTO
Her sistem için iki soru sorulur:
- RPO – Ne kadar veri kaybedebiliriz? Günlük yedek alınan bir sistemde en kötü durumda bir günlük veri kaybolur. Saniyeler düzeyinde RPO, sürekli replikasyon gerektirir.
- RTO – Ne kadar süre durabiliriz? Dakikalar düzeyinde RTO, hazır bekleyen bir DR altyapısı ve otomasyon gerektirir; günler düzeyinde RTO için yedekten geri yükleme yeterli olabilir.
Tüm sistemlere en iddialı hedefi koymak maliyeti gereksiz artırır. Sistemler kritikliğe göre sınıflandırılır:
| Sınıf | Örnek sistemler | Tipik hedef |
|---|---|---|
| Kritik | ERP, sipariş, ödeme, hastane bilgi sistemi | RPO dakikalar, RTO birkaç saat |
| Önemli | E-posta, dosya sunucuları, CRM | RPO saatler, RTO bir iş günü |
| Destekleyici | Test ortamları, arşivler | RPO bir gün, RTO birkaç gün |
Yedekleme mimarisi: 3-2-1 kuralı
Klasik ve hala geçerli kural: Verinin üç kopyası, iki farklı ortamda, bir kopyası başka bir lokasyonda. Fidye yazılımı çağında buna iki madde eklenir: bir kopya değiştirilemez (immutable) veya ağdan ayrık olmalı ve geri dönüş testlerinde sıfır hata görülmelidir.
- Birincil yedek: Hızlı geri dönüş için yerinde, disk tabanlı yedekleme deposu.
- İkincil kopya: Farklı lokasyonda (DR merkezi, bulut veya F2 Cloud) tutulan kopya.
- Değiştirilemez kopya: Belirli bir süre boyunca hiç kimsenin, yönetici dahil, silemediği veya değiştiremediği yedek; ExaGrid gibi fidye yazılımına dayanıklı depolama çözümleri veya değiştirilemez nesne depolama ile sağlanır.
DR seçenekleri
| Model | Nasıl çalışır? | Uygun olduğu durum |
|---|---|---|
| Yedekten geri yükleme | Felakette altyapı yeniden kurulur, yedekten dönülür | RTO’su günler olabilen sistemler |
| Soğuk / ılık DR merkezi | İkinci lokasyonda altyapı hazır, veri periyodik kopyalanır | Orta kritiklikteki sistemler |
| Sıcak DR / replikasyon | Sanal makineler sürekli ikinci lokasyona çoğaltılır, dakikalar içinde açılır | Kritik sistemler |
| Hizmet olarak DR (DRaaS) | Replikasyon hedefi bir servis sağlayıcının veri merkezidir | Kendi ikinci merkezini kurmak istemeyen kurumlar |
DR yalnızca sunuculardan ibaret değildir: İkinci lokasyonda ağ, firewall kuralları, VPN erişimi, DNS kayıtları ve kullanıcıların sistemlere nasıl ulaşacağı da planlanmalıdır.
Runbook: felaket anında kim, neyi, hangi sırayla yapacak?
DR planının kalbi, adım adım yazılmış kurtarma kılavuzudur (runbook). İçinde şunlar bulunur:
- DR ilan etme kararını kimin vereceği ve iletişim zinciri,
- Sistemlerin bağımlılık sırasına göre açılış sırası (önce kimlik doğrulama ve veritabanları, sonra uygulamalar),
- Ağ ve DNS değişiklikleri,
- Her adımın doğrulama ölçütü,
- Birincil merkeze geri dönüş (failback) prosedürü.
Test etmediğiniz yedek, yedek değildir
Yedekleme işlerinin “başarılı” görünmesi, geri dönüşün çalışacağını garanti etmez. Önerilen test düzeni:
- Otomatik doğrulama: Yedekleme yazılımının sanal makineleri izole ortamda açıp çalıştığını doğrulaması (Veeam SureBackup gibi).
- Periyodik geri dönüş testi: Üç ayda bir seçilen dosya, veritabanı ve sanal makinelerin geri yüklenmesi.
- Yıllık DR tatbikatı: Kritik sistemlerin DR lokasyonunda açılması, kullanıcı testleri ve sürenin RTO ile karşılaştırılması.
Her testin sonucu raporlanmalı; hedeflere ulaşılamadıysa plan ve altyapı güncellenmelidir.
Sanallaştırma ve depolama ile birlikte düşünün
Yedekleme ve DR performansı, birincil altyapının tasarımına bağlıdır. Depolama performansı, sanallaştırma platformu (VMware, Microsoft Hyper-V veya Red Hat gibi KVM tabanlı çözümler) ve ağ bant genişliği, yedekleme pencerelerini ve replikasyon gecikmesini doğrudan etkiler. Sunucu ve depolama yenileme projeleri, DR tasarımını iyileştirmek için doğru zamandır. KVM tabanlı sanallaştırmaya geçişi değerlendiriyorsanız Red Hat çözüm merkezimizi inceleyebilirsiniz.
F2 yaklaşımı: Sistemlerinizi kritikliğe göre sınıflandırıp RPO/RTO hedeflerini birlikte belirliyor; Veeam ve ExaGrid tabanlı yedekleme, IBM, NetApp ve Pure Storage depolama ile F2 Cloud felaket kurtarma hizmetlerini tek mimaride kuruyoruz. Runbook’u yazıyor, ilk DR tatbikatını sizinle birlikte yapıyoruz.
